VoiceStudio:把 ElevenLabs 搬回自己的电脑
2026 年 11 月 9 日,debpalash/VoiceStudio 是 105,704 个 Star、11,746 个 Fork、101 个 open issue,7,078 次提交,最新版本 v0.5.8-beta.3。仓库 4 月 9 日才建,Python 为主,AGPL-3.0。
涨得快到连自家页面都跟不上:README 顶部还挂着「🎉 100,000 GitHub stars — thank you!」,官网首页的计数器停在 82,040 Star / v0.5.6,而官方界面截图里那个「Star 93,256」的按钮,又是另一个时间点的快照。三个数字对不上,恰好说明这半年发生了什么。
它的定位一句话就能讲完:「开源、完全本地运行的 ElevenLabs 替代品」——声音克隆、音色设计、视频配音、听写、转写、有声书,官方称覆盖 646 种语言,跑在你自己的笔记本、台式机、服务器、手机和平板上,不需要账号。
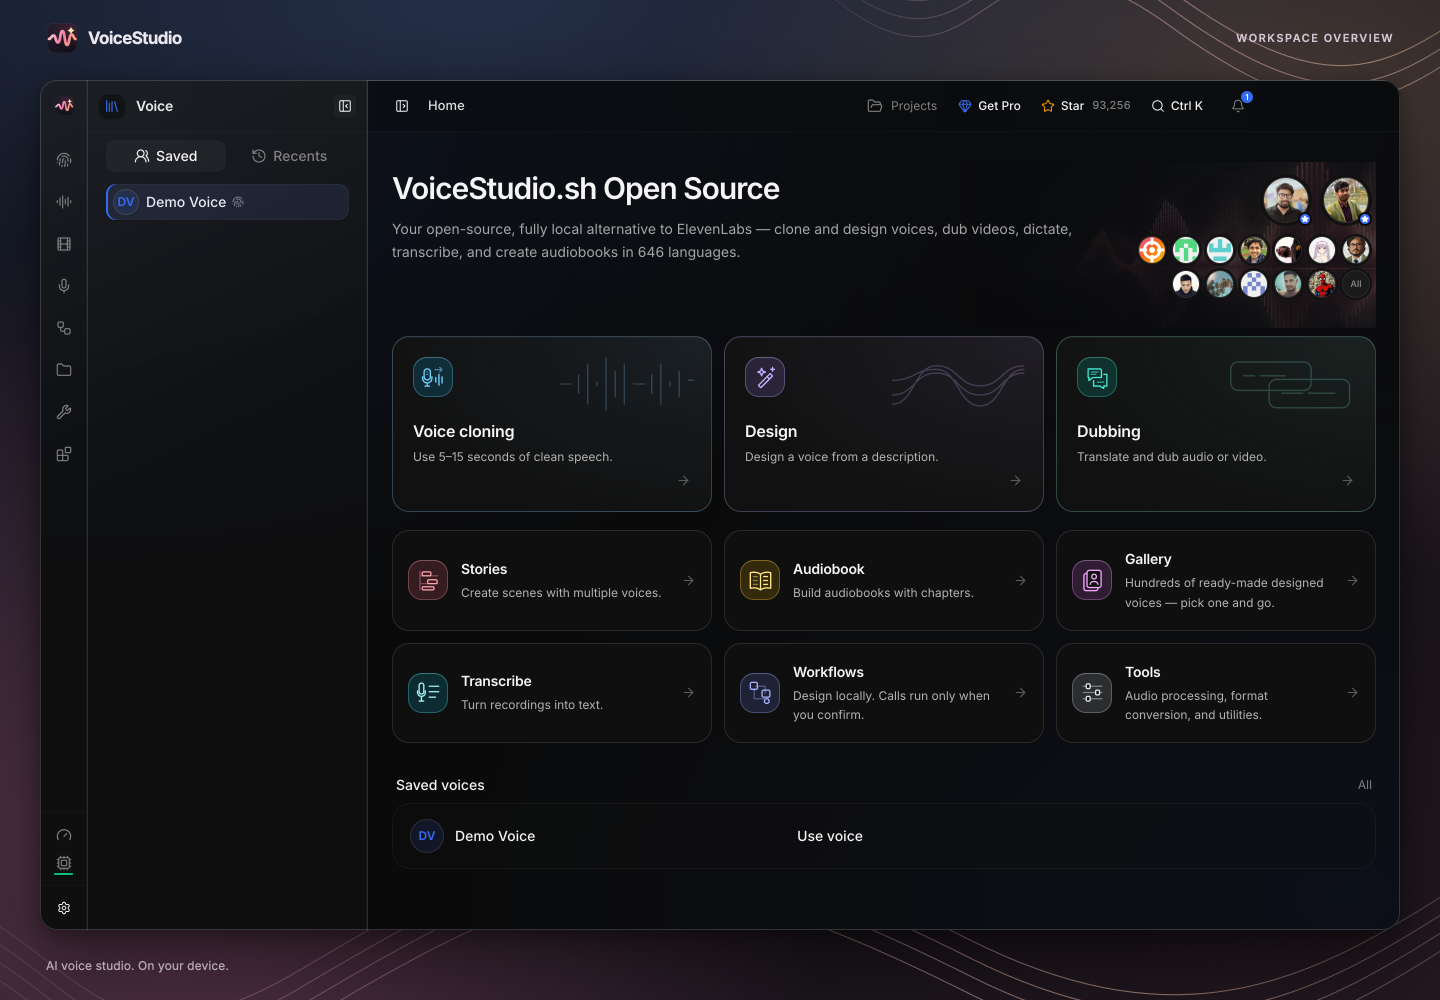
工作台首页。Voice cloning、Design、Dubbing、Stories、Audiobook、Gallery、Transcribe、Workflows、Tools 九个入口,左侧是已保存的音色;右上角那个 Star 数还停在 93,256。截图来自官方仓库。
一个桌面壳,装下整条语音生产线
它不像多数 TTS 项目只给一个命令行或 API,而是把整条链路做成了图形界面:用一段 5–15 秒干净录音克隆音色;用一句自然语言描述「造」一个不存在的声音;把视频翻译配音到另一种语言并尽量对齐原时间轴;悬浮听写组件、本地转写、多角色故事、按章节朗读的有声书、批量队列。功能目录里还列着人声分离、说话人分离、发音词典、AI 水印、MCP Server。
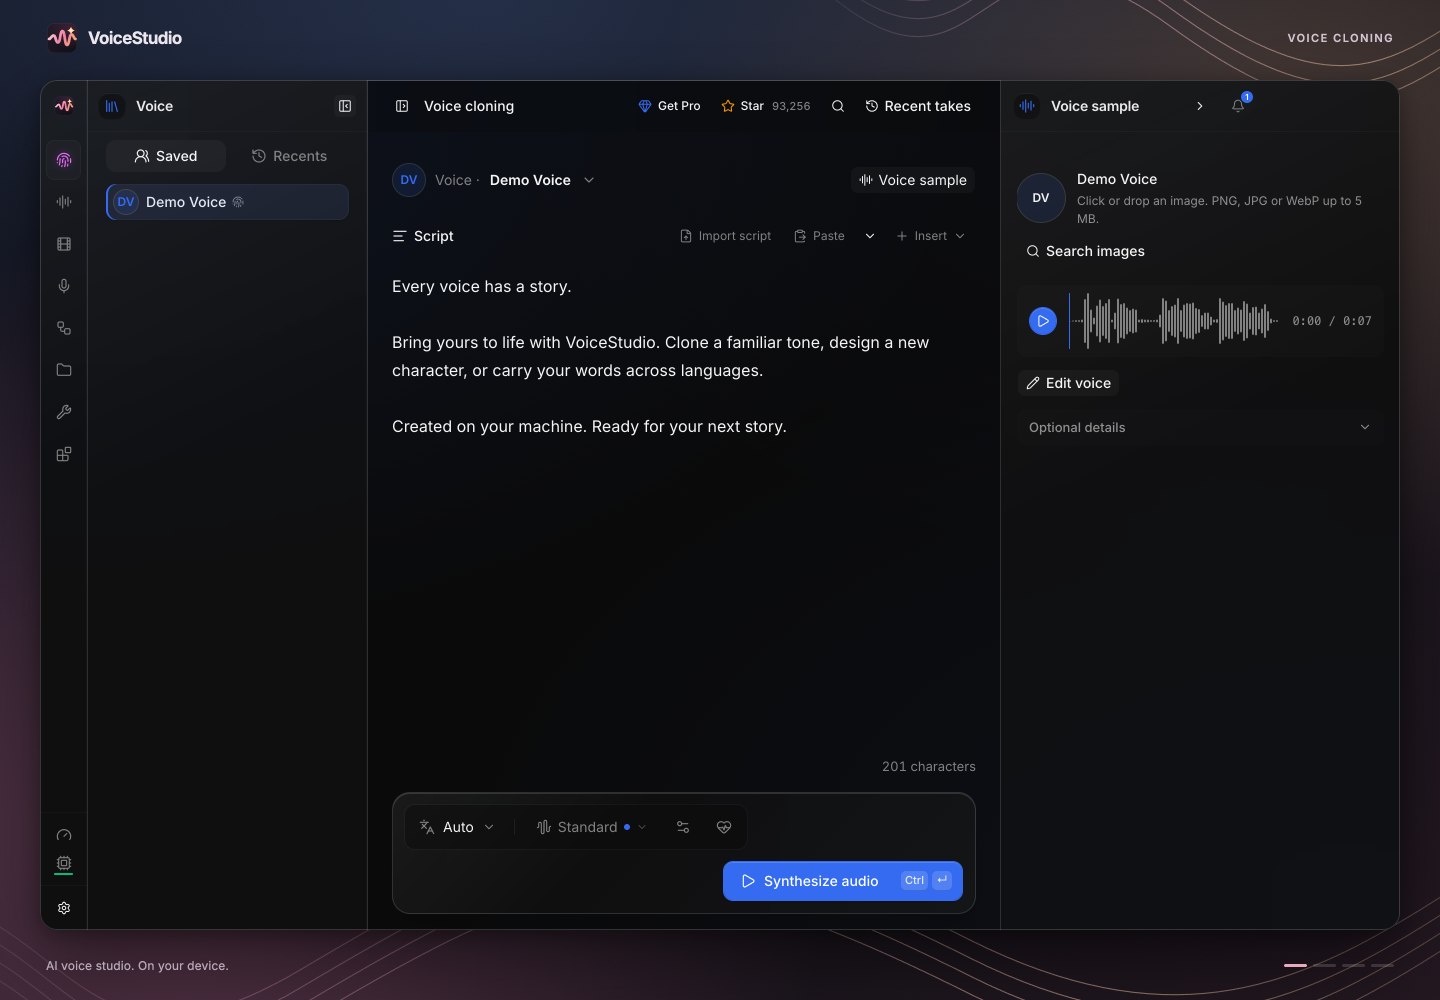
声音克隆。左中输入脚本,右侧放参考音频(Demo Voice 是 7 秒样本、带波形),底部 Synthesize audio 一键合成。README 建议参考录音 5–15 秒且尽量干净。
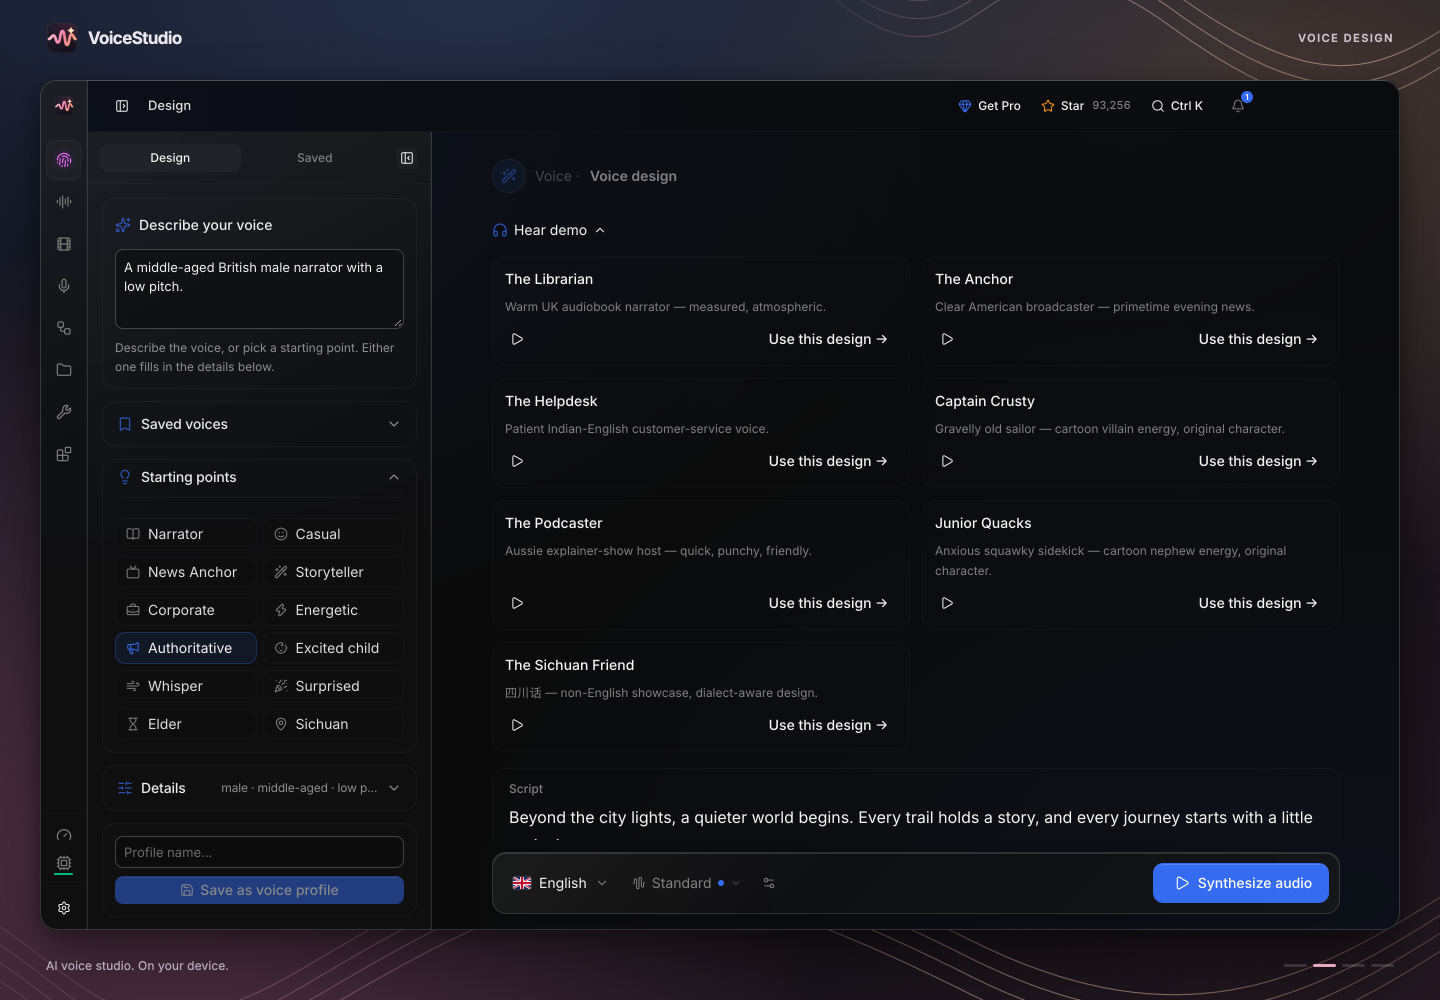
音色设计。不给参考录音,改用文字描述音色特征来生成——这是它与「必须先有一段人声」的克隆工具最直观的差别。
视频配音是最能看出产品野心的一块:
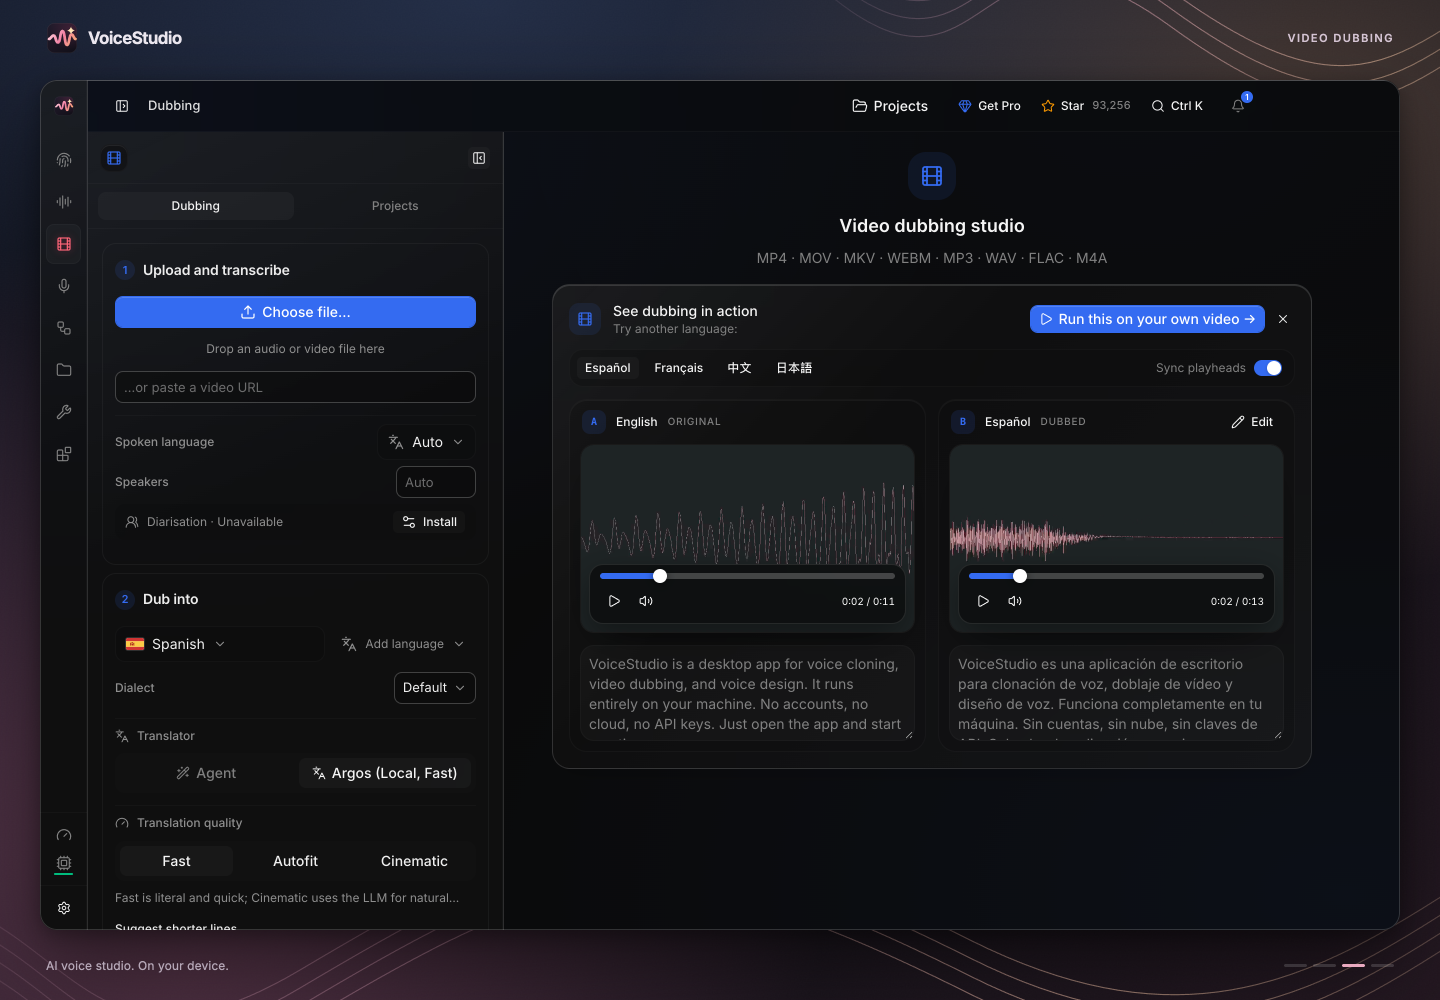
视频配音。左侧两步向导:上传并转写(可选自动识别语言、说话人分离、翻译引擎),再选择目标语言与方言;右侧并排显示原文与译文的波形和文本,带 Sync playheads 同步播放头。截图里的翻译器是本地的 Argos,格式支持 MP4 / MOV / MKV / WEBM / MP3 / WAV / FLAC / M4A。
关于「646 种语言」,得补一句口径。它来自 docs/languages.md,统计的是默认 OmniVoice 引擎的目录:646 种语言、合计 58.1 万小时训练数据;其他引擎各有自己的语言集,选到不支持的语言会直接停止合成并报出引擎名和可用选项,而不是硬凑一个错误的发音。文档还细分了巴西/欧洲葡萄牙语、维吾尔语,以及阿拉伯语等从右向左文本的编辑方向。但表格里不少语言只有几小时到十几小时训练数据,最少的一行是 0.05 小时——官网自己写着「语言数量不是质量排名」。646 是覆盖面,不是 646 种都达到商用级自然度。
「完全本地」到底意味着什么
本地闭环:本文依据仓库文档与官网许可说明绘制。
拆开看是两层。桌面壳是 Electron + React(Bun 管理),后面挂一个本地 Python 服务(FastAPI),默认绑定 127.0.0.1:3900——之所以不绑 0.0.0.0,是因为后端本身不带认证,真要对外暴露得自己配 OMNIVOICE_API_KEY。这个服务同时提供 OpenAI 兼容的音频接口和 MCP,所以脚本、Agent、Claude Code 之类可以直接调用;仓库还提供 npx skills add debpalash/VoiceStudio 让 Agent 自己完成安装、硬件检测和一次试生成。
模型不是打包塞给你的,而是 Model Manager 按需下载,且下载前会先问你。默认引擎是 k2-fsa/OmniVoice,目录里还有 CosyVoice 3、KittenTTS、VoxCPM2、IndexTTS 2.5、GPT-SoVITS、各类 GGUF 引擎;转写侧默认 WhisperX,另有 Faster-Whisper、MLX Whisper、sherpa-onnx 等。硬件路径覆盖 NVIDIA CUDA、Apple Silicon Metal、AMD ROCm(可选)、GGUF 的 Vulkan 加速,没有 GPU 也能在 CPU 上跑,只是慢。使用统计是明确 opt-in 的,不是默认上传。
官网上那张与 ElevenLabs Cloud 的对照表,最关键的一行是 Your audio:VoiceStudio 是 Stays local,云端服务是 Uploaded。对播客、内训视频、医疗或法务录音这类「音频不能出内网」的场景,这才是真正被解决的需求,而不是省下每月订阅费。
引擎可换,是它最务实的设计
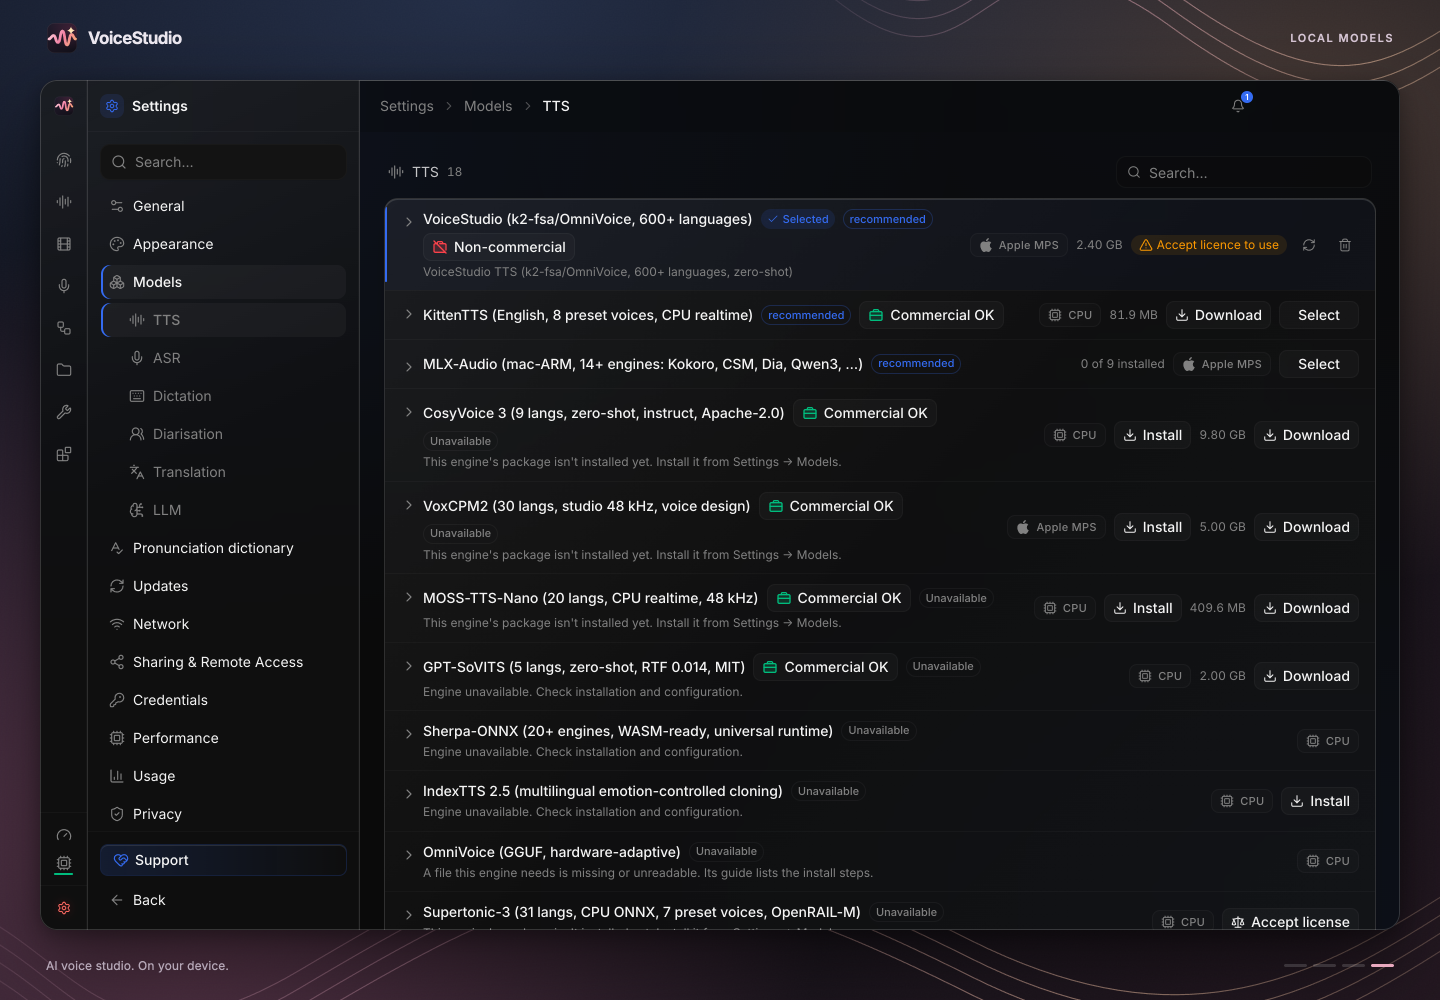
Settings → Models → TTS。这张截图里最值得看的不是「TTS 18」这个数量,而是每个引擎旁边的许可标签:默认的 VoiceStudio TTS(k2-fsa/OmniVoice,600+ languages,2.40 GB)标着 Non-commercial,右侧要你 Accept licence to use;KittenTTS(81.9 MB)、CosyVoice 3(Apache-2.0)、VoxCPM2、MOSS-TTS-Nano、GPT-SoVITS(MIT)则标着 Commercial OK。
这套「可插拔引擎」不只是为了追新模型,更是为了让用户绕开许可问题——下面这节就是全篇最该划重点的地方。
「AGPL 可商用」要分两层看
第一层是应用。 官网许可页写得很清楚:AGPL-3.0 允许你运行它做任何事,包括在工作中、用来赚钱;读源码、改源码、分发改动都行,商用本身不需要另买 App 许可。但 AGPL 比 GPL 多一条:如果你改了它并作为网络服务提供给别人用(Web App、内部工具、托管 API),就必须向这些用户提供修改后的源码,哪怕你从没交付过程序副本。官网还专门澄清,买 Pro 或 Lifetime 席位并不会自动获得闭源或私有托管的权利。
第二层是模型。 应用许可和模型权重、音色素材、生成输出的许可是分开的。官网原文:「A paid Pro, Lifetime or Enterprise app licence does not automatically grant rights to model weights…」;并直接点名 OmniVoice 预训练模型是 noncommercial。也就是说,默认那套「开箱即用、646 语言」的引擎,恰恰是不能拿去做商业交付的;要商用,就得在 Model Manager 里换成标着 Commercial OK 的引擎,并逐个确认上游条款。仓库另有 LICENSE-NOTICE.md 和模型清单,界面里也有「Accept licence to use」的确认动作。
还有第三层,是人的权利:README 写着「Clone a voice only with its owner's permission」。克隆他人声音做商用,除了模型条款,还要过本人授权与各地人格权、个人信息规则这一关;项目里那个 AI 水印功能是辅助,不构成免责。
顺带看清商业边界:AGPL 主程序永久免费、无需账号;Pro(官网对照表标 $99/年或 $199,查证日期 2026-10-04)卖的是商业许可、一人三设备、把任务派给其他 GPU、优先更新,且是闭源构建、需要账号;Cloud 是尚未上线的托管 API。典型的 open-core 结构:开源的是工作台,卖的是合规便利与算力。仓库里还留着前身 OmniVoice Studio 的痕迹(包名、环境变量 OMNIVOICE_*、Docker Hub 镜像名),0.5.3 之前用的是 Tauri,后来才迁到 Electron。
上手与边界
# macOS / Linux
curl -fsSL https://voicestudio.sh/install | sh
# Windows PowerShell
irm https://voicestudio.sh/install.ps1 | iex
# macOS Homebrew
brew tap debpalash/tap && brew install --cask debpalash/tap/voicestudio
# Docker(CPU 版,跑完打开 http://localhost:3900)
docker run -d --name omnivoice -p 127.0.0.1:3900:3900 ghcr.io/debpalash/voicestudio:stable
装完打开 Voice cloning,选一个音色或添加干净的参考录音,输入文本,生成;第一次用到某模型时应用会先征求下载同意。平台覆盖 macOS 13.3+(Apple Silicon)、Windows 10/11 x64、Linux x64、Docker,Android 10+ 与 iOS / iPadOS 17+ 是预览版、模型下载后可离线。几个例外要记住:Intel Mac 只能跑 UI、需连到别的机器上的后端;Windows on ARM 是实验性,x64 Python 后端走模拟;macOS 提示「应用已损坏」通常是 Gatekeeper 拦截,不是包坏了。
也别忽略现实约束:v0.5.8-beta.3 还没到 1.0,beta 一天能发好几版,手机端仍是 Preview,社区项目没有 SLA;首次下模型会吃掉磁盘与显存(截图里从 81.9 MB 到 9.80 GB 都有);CPU 可用但体感慢。
一个判断
它火成这样,原因不是「免费版 ElevenLabs」这么简单。真正被合并到一起的是三件云端 TTS 很难同时给的东西:音频不出本机、模型可自由替换、本地 API 与 MCP 能被脚本和 Agent 直接调用。对内容团队,这是把配音和转写从「按次付费的网页」变成「本机的一条流水线」;对开发者,它更像一个可编排的本地语音服务,只是恰好带了个好看的桌面界面。
但要提醒一句:开源的是工作台,不是「随便商用的语音模型」。把它当本地音频基础设施,判断成立;当成零成本商用配音服务,大概率会在许可上翻车。个人用、内部用可以直接装;真要交付客户,先去 Settings → Models 看清许可标签,换到 Commercial OK 的引擎,再确认参考音色的授权——这一步省不掉。
配图与参考
文中 5 张界面截图来自官方仓库 docs/media/electron/(VoiceStudio,AGPL-3.0),仅作介绍用途;本地闭环示意图为本文绘制。
- debpalash/VoiceStudio · 官网 · README
- 官方文档:Supported Languages · Features and engines · License & responsible use
- AGPL-3.0 and commercial licensing · 官网与 ElevenLabs 对照表
- 文中 Star、Fork、issue、提交数与版本号取自 2026-11-09 的 GitHub API 与仓库页面;官网计数器与 Pro 价格为页面标注口径,价格以官方最新条款为准