ThinkRail 的定位是"会自己变强的 agentic IDE"——今天靠活的规格了解你的项目,明天靠扩展自己长出能力。
前几篇都是给现有 agent 加能力的技能,这一篇不一样:它是一个工作台。装它不是「加个技能」,是把写代码的地方换掉。
| 项目 | 内容 |
|---|---|
| 类型 | 应用(agentic IDE,桌面 app + CLI) |
| 仓库 | JetBrains/thinkrail |
| 技术栈 | Bun + pi(内核)+ React 19 + Monaco + Electrobun |
| 许可 | Apache-2.0 |
| 热度 | 6.8k star / 368 fork / 310 open issue(2026-10-31 快照) |
| 状态 | v0.3.0(2026-10-29),nightly 每天发,JetBrains 孵化项目 |
它是什么,不是什么
先说清楚三件事:
- 不是 JetBrains IDE 的插件。 它是独立应用——Electrobun 打包的桌面程序,或者
thinkrail这个 CLI 在浏览器里打开同一套界面。 - 不自己带模型。 内核是
pi,一个刻意做得极简的 coding agent。ThinkRail 是个瘦宿主:在进程内跑 pi,把它桥接到一套完整的 Web UI 上。 - 不重造你的配置。 它直接读你现有的
~/.pi/agent,skills 原地读、MCP 读 pi 的mcp.json。
理解这一点,后面所有设计才说得通:它做的不是「更强的 agent」,是「agent 外面该有什么」。
它想解决的三个问题
项目自己的 goal-and-requirements.md 里写了段很少见的坦白——先说 pi 的好处,再说它的代价:
pi 是一个刻意极简、可扩展的 harness。这种灵活是要花时间的:新人要花很久才学会怎么开它,老手仍然觉得终端里围着 agent 转的那些活很笨拙。
然后列了三条具体的:
- 并行的 agent 在同一个工作树里互相踩,还会踩到你自己没提交的改动。
- 从 CLI 审查改动很痛苦:读 diff、在具体那一行上评论、再把反馈交回给 agent,三件事都很别扭。
- 意图会蒸发。聊天里做过的决定随会话结束而消失,下一次要么重新推导,要么自相矛盾。
这三条几乎就是这个产品的目录。下面三个设计一一对应。
设计一:工作区就是 git worktree
打开任意 git 仓库作为一个 project,从它上面切出 workspace——每个 workspace 是一个 git worktree,有自己的分支和工作目录。
于是 agent 在 ws-1、ws-2、ws-3 里并行干活,碰不到你的 checkout。干完合并好的分支、删掉其余的。
这套机制还有几个细节,都是踩过坑才想得出来的:
- 已完成或闲置的 workspace 会自己「沉」到每个 project 的 Settled 搁架上——PR 合并/关闭时,或者闲了一周之后;你一动它,它立刻回来。
- 顶栏直接显示当前分支相对
origin的位置和它的 PR 状态,下一步就一个按钮:发布、推送,或者开 PR(描述可以从计划、从提交、从你的 PR 模板、或让 agent 写一稿)。 - PR 开着之后,CI 的检查和评审结论都在里面;可以标记 ready、把失败的检查或分叉的分支丢回给 agent、用仓库上次用过的方法合并。
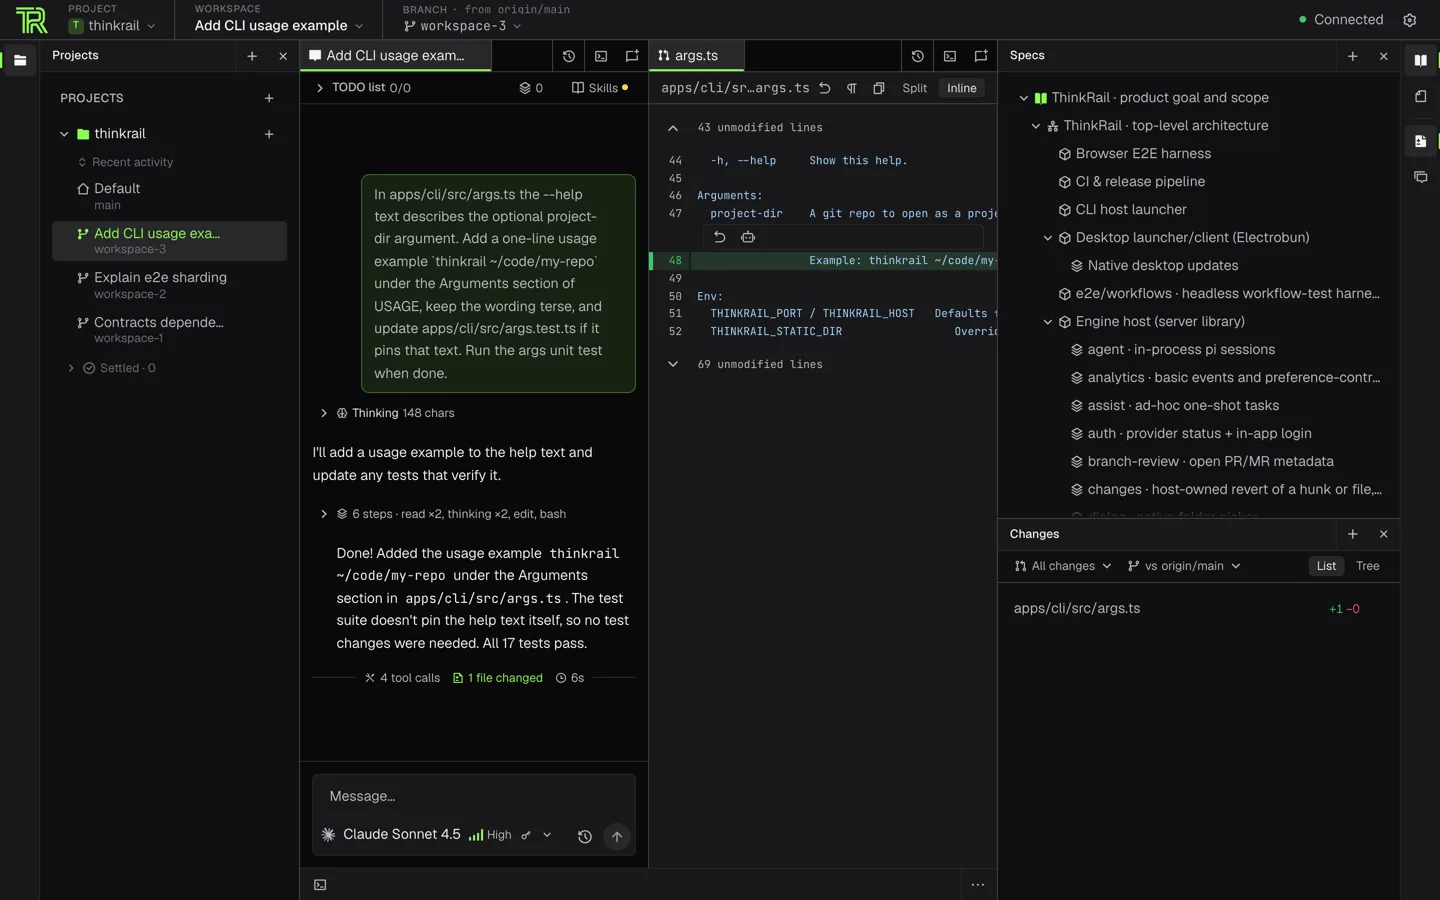
截图里能看清这个骨架:最左是 project 和三个 workspace(ws-3 正在干活,另外两个已经沉到下面),中间是这次会话的完整轨迹——TODO 清单、思考、6 步工具调用、以及「4 tool calls · 1 file changed · 6s」的收尾;右上是这次要改的文件,右下是 Specs 树和 Changes。
worktree 隔离是目前对「agent 乱改我的工作区」最实用的答案。 比要求 agent「小心一点」靠谱得多,也比让它在一个共享目录里抢文件强。
设计二:把 IDE 那部分真的做出来
不是「聊天框旁边挂个文件树」。它有的是:可拆分的 Monaco 标签页、带实时 git 变更标记的 Files 树和 Changed 视图、终端、文档,全部按当前 workspace 作用域。
关键的一处是审查:你可以像 code review 那样在文件和 diff 上留锚定评论,然后把这一串评论作为结构化上下文发给 chat。这就把第 2 条痛点闭合了——不是在终端里贴 diff 片段,而是「指到行、说一句、交回去」。
另外,每个 chat 有自己的模型选择,带实时 token 和花费读数;跑着的回合可以被插话(steer),也可以排队下一句;可以派给子 agent;计划和 agent 共用一份,它改你也改,每一步做完都能单独提交和审。
设计三:Specs,让意图活过会话
这是三个设计里最有野心、也最容易翻车的一个。
做法是:在代码旁边维护一张连通的 SPEC.md 图谱,agent 通过专门的 spec_* 工具读它、搜它、维护它。于是「当初为什么这么决定」不再只存在于那一次对话里。只读的 Specs 工具把这张图渲染成树。
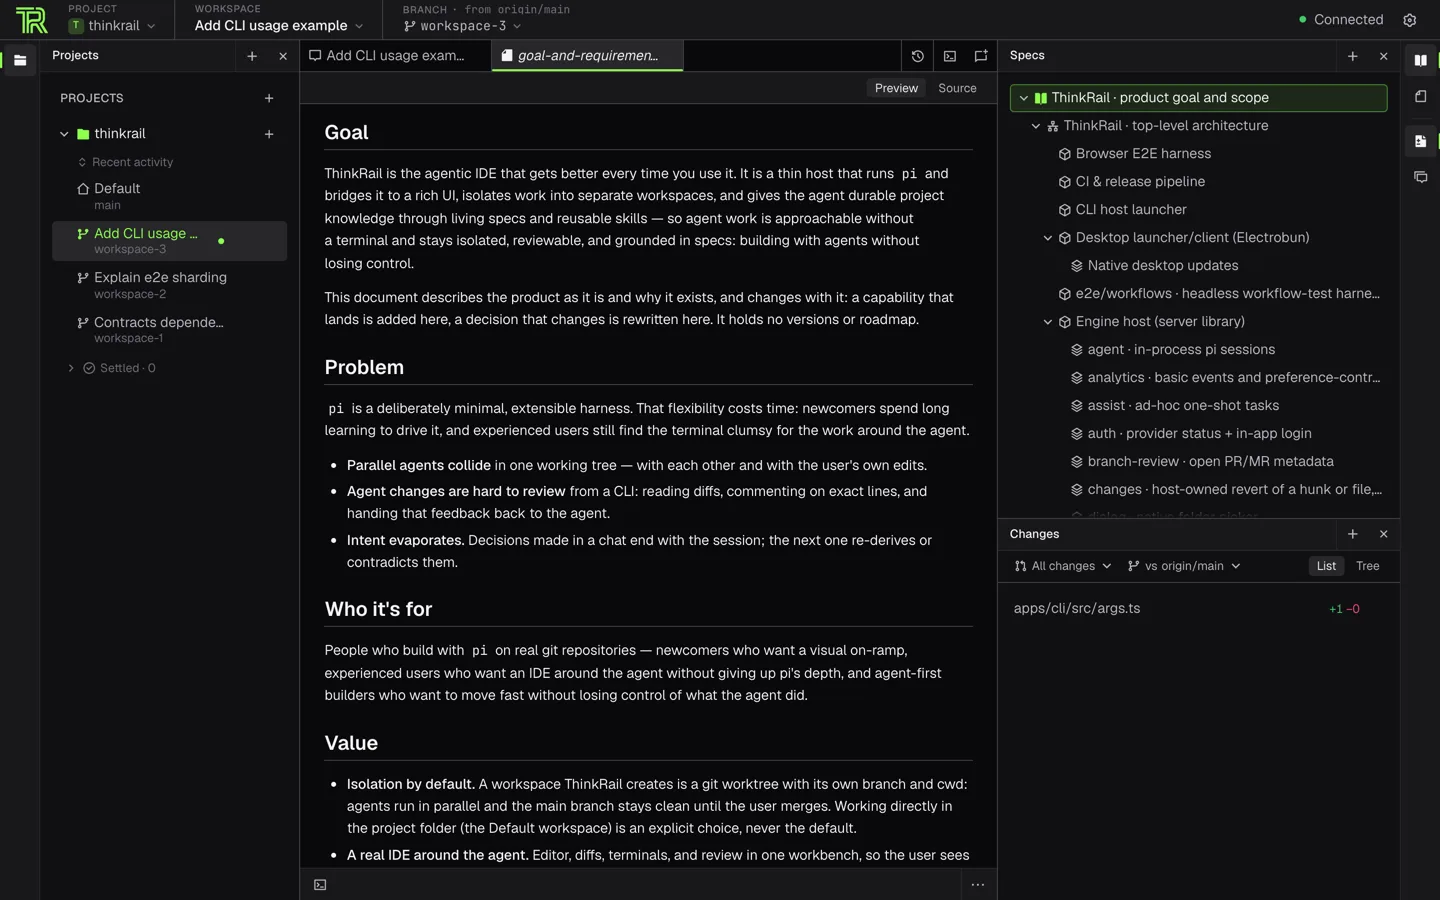
上面那张截图里渲染的正是产品自己的目标文档,分 Goal / Problem / Who it's for / Value 几节,右边树上每个节点挂一句摘要。思路很清楚:把意图做成可以 diff 的产物。
对多 agent 协作来说这一步其实是被逼出来的——三个 agent 并行改不同的分支,如果没有一份共享的「我们要做什么」,「你以为的一致」很快就会分叉。
代价也明显:spec 图是要人维护的。它自己声明是 spec-first 开发(每个模块旁边一个 SPEC.md,动了边界/契约/决策就在同一次改动里更新 spec),但一个四人团队能不能守住这个纪律,是另一回事。
架构:一个值得抄的瘦宿主
「Under the hood」那一节写得很干净,三个环:
- Engine host(
packages/server+packages/shared):Bun.serve起的 HTTP + WebSocket 宿主,每个 chat 一个进程内 pi 会话,由apps/cli或apps/desktop拉起。 - The wire(
packages/contracts):宿主和 UI 之间带类型、带版本的协议。 - UI client(
apps/web):React 19 + Zustand + Tailwind v4,独立发布,只依赖 contracts。
第三条是重点:前端可以单独发版,因为它只认那份协议。这在「IDE 这种永远在改的东西」上是很省事的结构。
还有一句我很喜欢的产品声明——
pi 拥有模型、技能、压缩、成本和会话状态;应用拥有工作区、编辑器和这条线——它永远不会在你背后拼装提示词。
生态姿态:不锁你
这类工具最容易犯的错是「来了就别走」。ThinkRail 反着做:
- 读你现有的
~/.pi/agent;想用另一份配置(比如~/.pi/agent-personal),在 Settings → Environment 里指过去,启动时设的环境变量优先。 - 你为别的 coding agent 攒的 Agent Skills,原地读取,不搬迁。
- MCP 服务器直接读 pi 的
mcp.json;对服务器没标只读的调用,它会先在 chat 里问你(或者在项目里信任某些工具);仓库自带的 server 默认是关的,等你批。 - 两个自研工具(结构化提问
ask-user-question、图表/对比/预览visualize)单独发成了 pi 包,装一下,终端里的裸 pi 也有同样的工具:
pi install npm:@thinkrail/pi-ask-user-question
pi install npm:@thinkrail/pi-visualize- 模型侧:JetBrains AI 登录,或者用 pi 自己的认证接任何 provider;想接公司网关或本机模型,Settings → Providers → Custom servers 支持任何 OpenAI 兼容服务(LiteLLM、sglang、vLLM、Ollama、LM Studio、llama.cpp),写进 pi 的
models.json,连piCLI 里都能选到。
顺带一提,界面内置简体中文、日文、俄文、西班牙文;缺语言就往 ~/.thinkrail/locales 丢一个 en.json 的翻译,保存即生效。
上手
# macOS / Linux(Windows 下用 Git Bash 也行)
curl -fsSL https://raw.githubusercontent.com/JetBrains/thinkrail/main/install.sh | bash

# 然后
thinkrail ~/code/my-repo
Windows 用 irm ... install.ps1 | iex。安装器会校验 SHA-256 再把 thinkrail 放进 PATH。不想用脚本就下桌面版:macOS 14+ 的 DMG(arm64 / x64)、Windows x64 的 setup ZIP、Linux x64/ARM64 的 setup tarball。
前置条件只有两样:git 在 PATH 里,以及一个模型 provider。第一次启动会引导你连 provider、选项目;没有仓库也行,「Start a new project」会在 ~/thinkrail 下建一个空 git 仓库。
thinkrail update / thinkrail uninstall(--remove-data 才会删 ~/.thinkrail)都是内置的。想自己编译:Bun 1.4.4 + Node ≥ 22.19,bun install && bun run dev。
坑
1. 平台门槛比想象中高
macOS 要 14+;Linux 桌面版要 glibc 2.38+,还得装 GTK 3、WebKitGTK 4.1、Ayatana AppIndicator 3、librsvg 2——按 README 的说法,Ubuntu 24.04 起步。签名状态也乱:Windows 和桌面安装包都签了,macOS 的 CLI 签了但还没公证,桌面 DMG 要靠 JetBrains 内部的发布流水线,早期发布的包可能仍未签名,会被 Gatekeeper 拦。
2. 310 个 open issue,v0.3.0,四个月
7 月开源、10 月底才到 0.3.0,nightly 每天一个版本。迭代快是真的,没打磨完也是真的——310 个未关 issue,而这个集合里前三个项目分别是 8、10、67,三个加一起还不到它的三分之一。上手前建议按自己的平台关键词搜一遍 issue。
3. 它的天花板跟着 pi 走
不锁生态是优点,但也意味着 agent 一侧的能力由 pi 决定:模型接入、技能、压缩策略、工具生态,都在上游。ThinkRail 能决定的是「外面这层」,决定不了「里面那个」。
4. 遥测:基础和错误报告是常开的
README 写得比多数项目清楚,但结论要看清:
- 基础使用事件(启动、建 chat、发消息、连 provider)总是采集,绑一个随机安装 ID;明确不含 prompt、代码、文件、凭据、账号身份。
- 错误报告也是始终发送,只包含错误类型/代码和它在 ThinkRail 自己代码里的位置,不含错误信息、路径、URL、项目内容。
- 「额外使用数据」才由开关控制,
thinkrail --no-analytics或THINKRAIL_NO_ANALYTICS=1关的也只是这一部分。 - 开着额外分享时,打包版可能打开一次博客做归因(把你这次安装和网站访问对上,30 天后过期),前提是你在网站上接受过营销 cookie 或当地不要求同意。
介意的话,这些都不是「关一个开关」能全清的,得知道边界在哪。
5. 孵化项目的去留问题
它挂着 JetBrains incubator 徽章。孵化项目有三种结局:长成正式产品、并进现有 IDE、或者停掉。现在这套东西如果哪天被吸收进 IntelliJ,这个仓库的独立性就没了——不影响你今天用,但影响你把它写进团队标准流程的决心。
6. 这是换工作台,不是装插件
要 git、要 provider、要迁移你的日常习惯。它换掉的恰恰是你最熟的那块地方,试错成本比装一个 skill 高一个量级。
适合谁
| 适合 | 不适合 |
|---|---|
| 已经在用 pi,想要一套正经 UI 的人 | 只想给现有 IDE 加个 agent 侧栏 |
| 经常让多个 agent 并行改不同分支 | 单人单分支、一次只做一件事 |
| 需要把「为什么这么改」留成可查的文档 | 团队没有写文档的习惯,也不打算有 |
| 愿意为 review 体验换一个编辑器 | 深度依赖 IntelliJ 全家桶的重构/调试能力 |
一点判断
它赌的是一个方向性判断:不是「IDE 加一个 agent 按钮」,而是「agent 需要一个 IDE」。
这个判断如果成立,那三个设计就是必然的:agent 要并行 → 必须隔离工作区(worktree);agent 要改代码 → 必须有人审(真 IDE 的 diff 和锚定评论);agent 要跨会话干活 → 必须有共享的意图(specs 图谱)。三条都是被 agent 的特性逼出来的,不是产品经理拍脑袋加的。
我最欣赏的是它没有重造 agent。模型、技能、压缩、成本全交给 pi,自己只做宿主、工作区和那条协议线。这让它能在四个月里做出这个完整度——但也让它永远受制于上游。
要泼的冷水有两盆。一是 spec 那套的自律成本:把意图做成可 diff 的产物很聪明,可一旦没人维护,那张图就会变成第二份过期文档,比没有更糟。二是 310 个未关 issue 和 0.3.0 的版本号——它现在是个值得试的工作台,还不是一个可以赌的工作台。