「看到一个喜欢的功能,想搞懂它怎么实现的——一直看到二进制那一层。」
这句话是 REA 的全部野心:把逆向工程从「一门要学五年的手艺」变成「一句能问出口的话」。
| 项目 | 内容 |
|---|---|
| 类型 | MCP 服务器 + CLI(附带 Agent Skill 说明) |
| 仓库 | morluto/rea · rea.tools |
| 技术栈 | TypeScript;Node 22.x / 24.x / 26.12.1+;npm 包 rea-agents |
| 许可 | MIT |
| 热度 | 41.4 万 star / 10.4 万 fork / 1420 open issue(2026-10-31 快照) |
| 状态 | v6.8.0(2026-10-25),2026-04-14 开源,仍在日更 |
41.4 万 star 这个数字值得先停一下:这个集合里前十个项目加起来也没这么多,而它才六个月。README 自己庆祝了「400,000 stars」。这类数字度量的是注意力和愿望——多少人想学逆向但没入门——不等于日活。
它是什么
一个本地 MCP 服务器。你的 agent 通过 MCP 调用它去检查目标、追踪代码,它返回结论 + 证据 + 局限,agent 再拿这些去解释行为、或者写一份自己的实现。
npx rea-agents setup装完会注册 MCP 服务器、装上配套的工作流说明、备份你原有配置。支持 Claude Code、Codex、Cursor、Gemini CLI、Grok Build 等,其他客户端可以手动注册 MCP。
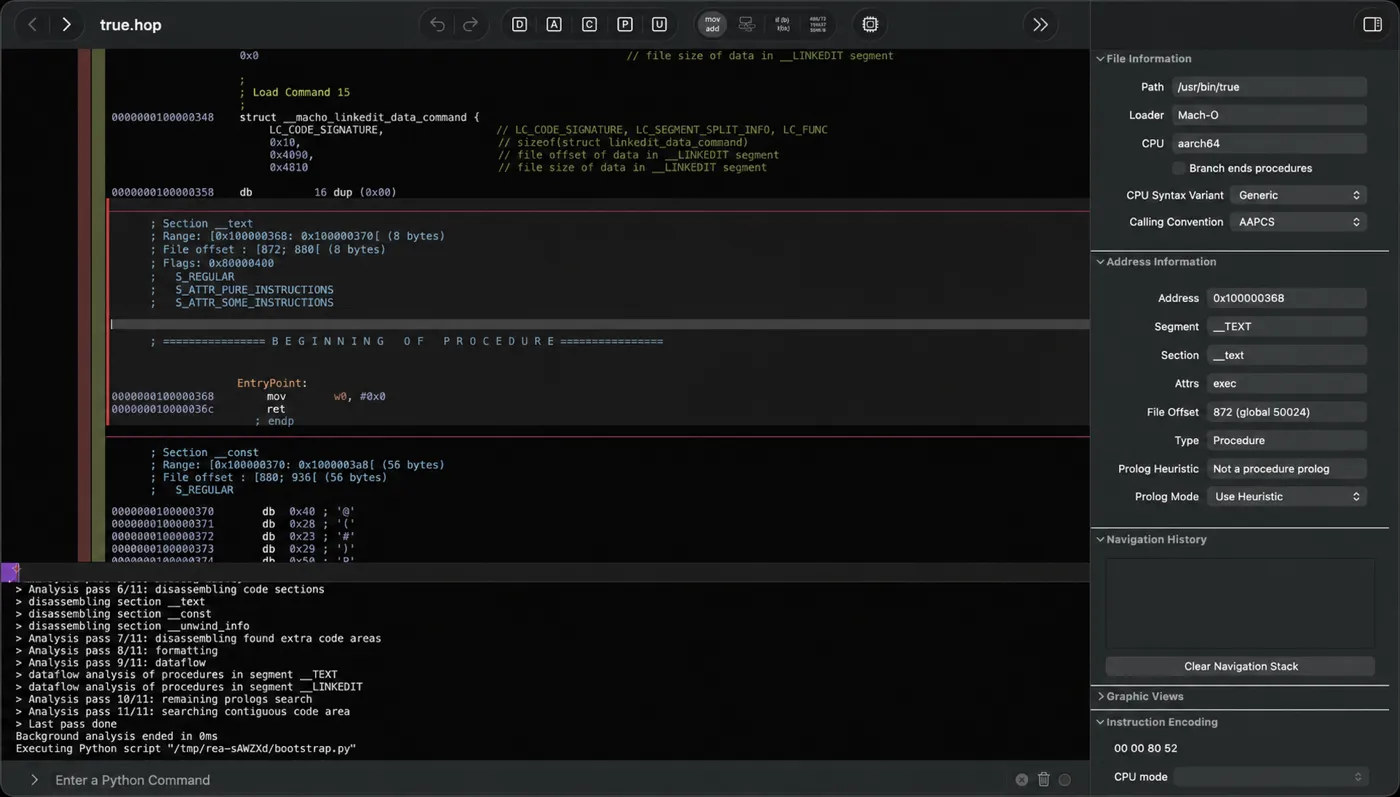
传统工具链(Hopper、Ghidra、IDA、Kuna)不用换——REA 是接进去的,不是替代。下面这张图的底部控制台里,REA 的 Python 桥正被注入 Hopper:
三十多种目标,最狠的是「不需要额外工具」的那一半
这是最能说明它工程量的一张表。我把 README 里的目标分成三类:
要商业/重型引擎的
原生二进制(Hopper / Ghidra / IDA / Kuna)→ 伪代码、汇编、字符串、符号、调用与引用。
自带静态解析、零依赖的
| 目标 | 它直接给你什么 |
|---|---|
| Go 二进制 | 内嵌的编译器版本、模块、替换关系、构建设置 |
| Rust 二进制 | cargo-auditable 里的 crate 名、版本、来源、依赖边 |
| GPU 代码对象 | CUDA/HIP 目标、kernel 参数与资源、保留的 PTX 文本 |
| 模型文件 | GGUF / safetensors 元数据、张量声明与推导总量 |
| IL2CPP(Unity) | global-metadata 里的程序集、类型与方法名、索引区间 |
| Godot PCK | 归档清单与解包、原始头部与目录事实 |
| PE 证书 | Authenticode 条目、PKCS#7 签名者与 X.509 身份字段 |
| PE 导入 | DLL 名、序号、IAT RVA、pefile import hash |
| ELF notes | PT_NOTE/SHT_NOTE 所有者、GNU build-id、ABI tag |
| Apple IPS 崩溃 | 线程、镜像、寄存器与崩溃分类 |
| Linux 内核模块 | .modinfo、__versions CRC、签名尾 |
| Erlang BEAM | IFF chunk、atom、导出导入、lambda |
| APK 签名 | v1/v2/v3/v3.1 签名者、证书指纹、密钥轮换 |
| Flutter 应用 | Dart snapshot 哈希、各 ABI 库摘要、引擎构建来源 |
| PyInstaller 程序 | CArchive 成员、Python 版本、入口脚本、提取的字节码 |
| .NET 程序集 | 元数据、CIL 指令、声明的原生依赖 |
要外部工具的
WASM(WABT)、EVM 字节码、SQLite、Android(adb / JADX / Apktool)、固件(binwalk / unblob)、抓包(tshark)、逻辑信号(sigrok)、JEB 项目。
再加上 JavaScript / Electron、网站页面、HAR / SAZ 网络捕获、进程行为录制。
读完这张表有个结论挺有意思:今天软件世界里最容易「看懂」的,恰恰是那些看起来最封闭的东西。 Go 和 Rust 的二进制里带着构建元数据,IL2CPP 有完整的元数据表,PyInstaller 直接把字节码打包进去,APK 必然带签名和资源表。所谓保护,很多只是打包,不是加密。
核心设计:结论必须带证据和局限
这是我最看重的一点,也是它和「让 AI 猜这段汇编在干嘛」的分界线。
REA 的每条结果都带 evidence 和 limitations——哪些是观测到的、哪些是推断的、哪些做不到。静态分析不运行程序;需要运行时,它明确写着「用你自己的权限运行或交互目标」,每份运行时指南单独说明副作用。
这和上一篇 security-audit 的 needs_validation 是同一种克制:给模型一个表达「我不确定」的位置。 没有这个位置,它就会用自信的语气把空白填满。
三个可验证的案例
它的 showcase 不是「看起来很厉害」,而是给了可复现的仓库:
- DX-Ball:跟一个音效调用进到 position-to-pan 的辅助函数,把不完整的伪代码还原成 C。结果是通过 3205 个原始 x86 用例,并复现了全部 63 个函数字节。
- Notion:从渲染进程的剪贴板 API 出发,穿过 preload 和 IPC 追到主进程,检查富文本剪贴板格式。
- TH04(PC-98 上的东方):从 16 位指令里还原固定角与瞄准角的计算,再和历史编译器的输出对比。
第三个特别能说明能力边界之外的品味:它挑的是一个 1997 年的 DOS 游戏——合法、无争议、纯技术。
另一个用法:造 RL 环境
README 里有一节不太起眼但很有意思:录一段 web 应用会话 → 把它的 API 变成工具 → 导出成一个 agent 能用的环境(AgentEnv),再自己加任务和奖励检查,用于强化学习或能力评测。
也就是说:同一个能力,既能读懂别人的产品,也能造一个仿真的练习场。 前者是研究,后者是训练,都不需要拿到源码。
它自己划的红线
DISCLAIMER.md 列了六条「不做」,写得比多数安全工具清楚:
- 绕过 DRM、许可校验、反作弊等技术保护措施;
- 开发游戏外挂,或篡改线上服务;
- 绕过你无权测试的系统上的认证、反爬或访问控制;
- 复制专有软件、复现它受保护的代码与资产;
- 规避模型供应商的用量政策与安全措施;
- 转售或共享 AI 账号与 API 访问权。
还有一句判据很关键:「软件公开可得、你手里有这个文件、你能连上调试端口,都不等于你对每一种操作都有授权。」
授权不等于占有。这条线在逆向这个领域里尤其重要,因为技术上能做和法理上能做,经常不是一回事。
上手
npx rea-agents setup          # 注册 MCP + 工作流说明,会备份原配置
# 或者纯命令行
npx -y rea-agents@latest analyze-javascript-application /path/to/app --json
装上之后的用法就是说话:
搞懂 Notes 应用里的搜索是怎么实现的,给我看证据,然后在我的项目里做一个类似的。原生深分析需要本机的 Hopper / Ghidra / IDA / Kuna;静态 JS 和 .NET 不需要任何引擎。Linux 上要有一个 procps 兼容的 ps(进程归属检查用)。
坑
1. 41 万 star 里有多少是「收藏了想学」
六个月 41 万 star、10 万 fork、1420 个未关 issue,同时 README 有 22 种语言版本。这是一个运营得非常好的项目,但 star 数在这里更像「多少人想学逆向」的计数器。判断它好不好用,看 issue 和 changelog 更实在——CHANGELOG.md 有 461KB。
2. 深分析还是要买商业工具
IDA Pro、Hopper、JEB 都得自己买正版,DISCLAIMER 明确写「REA 不提供任何商业工具许可、密钥或激活权限」,而且「破解版、盗用密钥、共享密钥都不被授权」。开源桥不等于送你授权。
3. 平台碎片是真实存在的
部分能力只在 Linux x64(EVM、pwntools 相关),Windows 上的 Ghidra 支持还是 experimental,Linux 要额外装 procps。别按 README 的总表以为处处都能跑。
4. 它不做「一键破解」
能力边界在看懂,不在绕过。它给你伪代码和证据,剩下你自己判断能不能用、该不该用。
5. 门槛降低是双刃的
把逆向降到「一句话」意味着好人更快,坏人也更快。它把红线写得很清楚,但技术上没有拦截——靠的是使用者的自觉和所在司法辖区的法律。
适合谁
| 适合 | 不适合 |
|---|---|
| 想搞懂某个产品怎么实现,再自己做一版 | 想找「一键去壳/去广告/破解」的 |
| 安全研究、恶意样本分析、CTF | 没有合法授权就想动别人的系统 |
| 老软件保存、格式逆向、互操作性开发 | 手上没有 Hopper/Ghidra/IDA 也不想装 |
| 想给 agent 造一个可交互的训练环境 | 只想要一个静态扫描器 |
一点判断
它真正的创新不是「AI 能反编译」——那件事早有人做——而是把证据做成了产品的一部分。
没有 evidence 和 limitations 的 AI 分析报告,本质上就是高级幻觉:语气笃定、细节丰富、经不起对照。REA 每给一个结论都要附上「哪一行、哪个符号、哪次观测」,这既是为了让你能验证,也是为了让它自己不能随口编。
第二个值得记的是它挑的目标。把三十多种格式列在一起之后你会发现,很多软件其实没在「保护」什么,只是在「打包」——Go 的构建信息、Rust 的依赖清单、Unity 的元数据表、Python 的字节码,全都原样躺在产物里。读得懂的人一直读得懂,只是以前读的人少。
这是这类工具最真实的意味:它没有打开新的门,它把门的钥匙复制了很多把。好事还是坏事,取决于拿到钥匙的人——所以那份 DISCLAIMER 写得越清楚,越说明作者知道自己在发什么。