给它一份 SRT 字幕和一套线稿,它按字幕讲故事的顺序,让一只笔把画面一笔一笔画出来。
这类工具最容易踩的坑是把「白板动画」理解成「图片加个擦除转场」。这个 Skill 值得写第一篇,是因为它把谁先出场和笔怎么走拆成了两件独立的事,而这两件事恰好是手绘视频做不像的两处死穴。
| 项目 | 内容 |
|---|---|
| 类型 | Agent Skill(SKILL.md + Python 脚本) |
| 仓库 | geeklee/srt-whiteboard-animation |
| 技术栈 | Python,opencv-python / numpy / av,不依赖 Manim |
| 许可 | MIT |
| 热度 | 5.2k star / 822 fork / 10 open issue(2026-10-31 快照) |
| 状态 | 2026-07-27 首次发布,此后无新提交 |
看一眼效果
仓库自带的示例:猴子山抢香蕉。字幕讲一句,画面上就长出一块内容,笔尖一直跟着正在走的线。
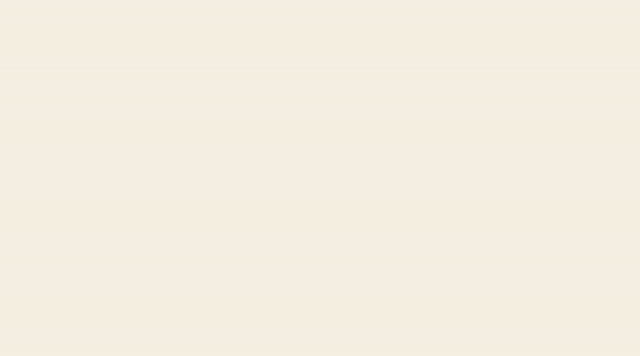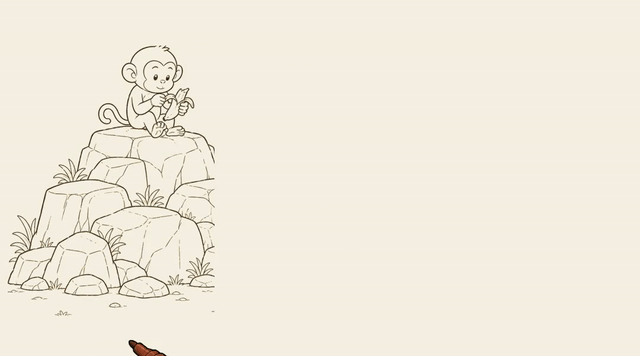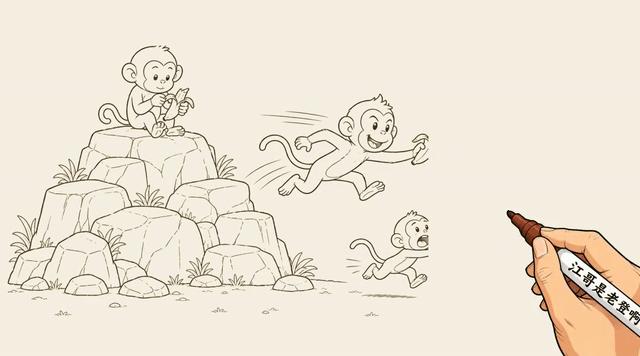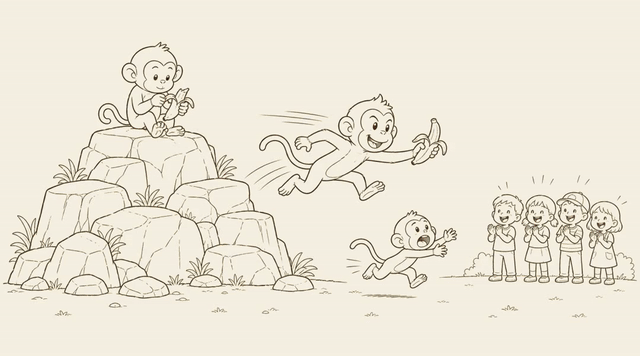
成片 8.6 秒、1080×600、60fps,只有画面——没有音轨,也没有字幕轨。SRT 在它这里只当编排依据用,字幕得自己在剪辑软件里压。
它到底做了什么
输入是 .srt 加一张(或几张)统一风格的线稿,输出是 MP4。中间没有「文生视频」那一套黑盒,全是可读的 JSON 和可调的参数:
parse_srt.py把字幕切成条,按 25–35 秒一幕给出分镜建议- 每一幕配一张 16:9 线稿(这步靠生图模型,不在 Skill 能力范围内)
- 人工标注
annotation.json:画面切成若干区域,每个区域绑一段字幕、一个出场序号 render_stream_whiteboard.py按标注逐幕渲染merge_scenes.py把多幕拼成一条
所以它本质上是个编排器,不是生成器。画面好不好看取决于你的线稿,它负责的是「什么时候画哪一块、笔怎么走完那一块」。
关键设计一:按字幕事件排序,而不是按坐标
这是它和大多数「图片渐显」脚本的分水岭。
标注里每个区域都带三个字段:sequence(出场序号)、subtitle(对应字幕原文)、narrativeRole(这块在叙事里干什么)。SKILL.md 要求的排序原则是:
场景铺垫 → 关键人物/物体 → 动作或变化 → 反应/结果
注意这不是「从左到右」。示例里左侧假山、中间抢香蕉的大猴、右侧围观小孩,恰好也是左中右,看着像坐标序;但一旦画面里主体交叠,或者故事从中间往两边展开,坐标序立刻失效。顺序的依据只能是字幕说了什么——SKILL.md 甚至专门写了一条:标注前必须同时读过字幕和看过原图,缺一项就先索取,不许凭字幕臆想画面。
关键设计二:遮罩,负责「不许提前露线」
顺序对了还不够。白板动画最出戏的瞬间,是画到一半,后面才该出现的东西已经隐隐透出来了。
它的解法是给每个区域算一张允许掩码:
允许掩码 = 本区域矩形 − 所有后续区域的矩形 − 本区域 protectedRegions落墨被限制在这张掩码里,于是后面区域天然碰不到。protectedRegions 是给「矩形切不准」兜底的——框大了、主体交叠了、背景线条可能泄露,就手工再圈一块禁区。
两个细节值得抄走:
- 掩码是逐帧生效的,未开始区域在任意时刻
t都不能露出一个像素,而不是「淡入」。 - 预览台里用等价的
destination-out演示同一套编排,所以你在浏览器里看到的揭示顺序,和最终成片是同一份语义。
关键设计三:一支笔连续走,不是一抹就出现
画法上它选了 stream:笔尖沿网格或骨架连续滑行落墨,先 ink 铺一遍灰度线稿,再回头 color 添彩,两段时间按 2:1 切。
| 参数 | 可选值 | 说明 |
|---|---|---|
--ink-path | grid(默认) | 网格路径,稳,任何线稿都能跑 |
skeleton | 骨架追踪,线稿清晰时笔迹更贴合轮廓 | |
--color-fill | contour-wipe(默认) | 沿轮廓扫描上色 |
brush | 沿轨迹刷,笔触感更重 |
因为是「一支笔在动」,同一幕内各区域在时间上必须串行:下一块的 startMs 要从前一块的 startMs + durationMs 接上,中间可以留 100–300ms 呼吸。startMs 写重叠了渲染器也不会报错,但画面上就是各画各的,白板的感觉没了。
时长估算有个土办法,SKILL.md 里写了:150 像素/秒 × 绘制距离。
七步流程,每一步都要停
这是我觉得最务实的一段设计——整个流程被切成七个带确认关卡的步骤,每步做完就停,等明确确认才继续:
| 步骤 | 产出 | 为什么必须停 |
|---|---|---|
| 1 | 字幕条 + 分镜建议 + 配图策略 | 分镜错了,后面全废 |
| 2 | 统一风格线稿(16:9) | 出图最贵,也最需要人眼判断 |
| 3 | annotation.json + 自动打开预览台 | 区域和叙事是否对得上,只你能判 |
| 4 | 区域编号检查图 | 编号、方向、越界,一眼能看出来 |
| 5 | 预览台调完时序并保存 | 时间轴只能靠拖,靠算没用 |
| 6 | 逐幕 MP4 | 渲染是唯一耗时的环节 |
| 7 | 合并成片 | — |
SKILL.md 把「没回复」「之前笼统授权过」「用户没反对」明确列为不算确认。这种写法在 Skill 里不多见,但对手绘视频这种返工成本高的任务,是对的。
上手
装
仓库没有写安装章节,按 Skill 的通用做法 clone 到你的 agent 的 skills 目录即可:
git clone https://github.com/geeklee/srt-whiteboard-animation.git \
  ~/.claude/skills/srt-whiteboard-animation
具体路径看你用的 agent。仓库里带了一份 agents/openai.yaml,说明作者主要在 Codex 里跑。
备环境
脚本自带独立的 .venv 准备逻辑,不污染全局:
python scripts/prepare_env.py --check   # 探测,成功后末行输出 ENV_PY=<路径>
python scripts/prepare_env.py           # 缺什么装什么
拿到 ENV_PY 后,后续渲染都用这个解释器。
切分镜
python scripts/parse_srt.py demo.srt --target-sec 30 --min-sec 25 --max-sec 3525–35 秒这个区间不是随手写的:白板动画信息密度低,一幕拖过 40 秒观众就开始走神。
打开预览台
不用起服务器,直接用 Chrome 或 Edge 打开 assets/preview.html,点「打开文件夹」选中场景目录,里面所有 同名.png + 同名.annotation.json 会一起载入。
能做的事:拖区域四边四角改 region、右侧改开始/结束毫秒(时长只读)、拖动列表调整顺序(自动重排 sequence)、选中模块自动高亮对应字幕、拖时间轴看揭示效果。改完点「保存」直接写回原 JSON。
写回依赖 File System Access API,Safari 和 Firefox 不行,只能下载后手动覆盖。
渲染与合并
<ENV_PY> scripts/render_stream_whiteboard.py \
  scene-01.png scene-01.annotation.json scene-01.mp4 assets/drawing-hand.png \
  --ink-path skeleton --color-fill contour-wipe

<ENV_PY> scripts/merge_scenes.py --inputs s1.mp4 s2.mp4 s3.mp4 --output final.mp4
渲染成功末行输出 OUTPUT=<路径>。不传 --total-ms 时用标注里的 sceneDurationMs,全部画完后自动补到该时长,并保证结尾至少停留 0.5 秒完整画面。
视觉规范是硬约束,不是建议
SKILL.md 里这一节写得比代码还硬:
- 纸张底色
#F5EBD7,渲染时从原图四角内缩取样染底,禁止纯白 - 深灰素描线条;红、橙、蓝只作少量概念点缀,不许有其他强调色
- 极简手绘、干净背景、大量留白
- 源图里不许出现任何文字——字母、数字、标签、字体全都算
- 不要写实、摄影感、3D、复杂纹理
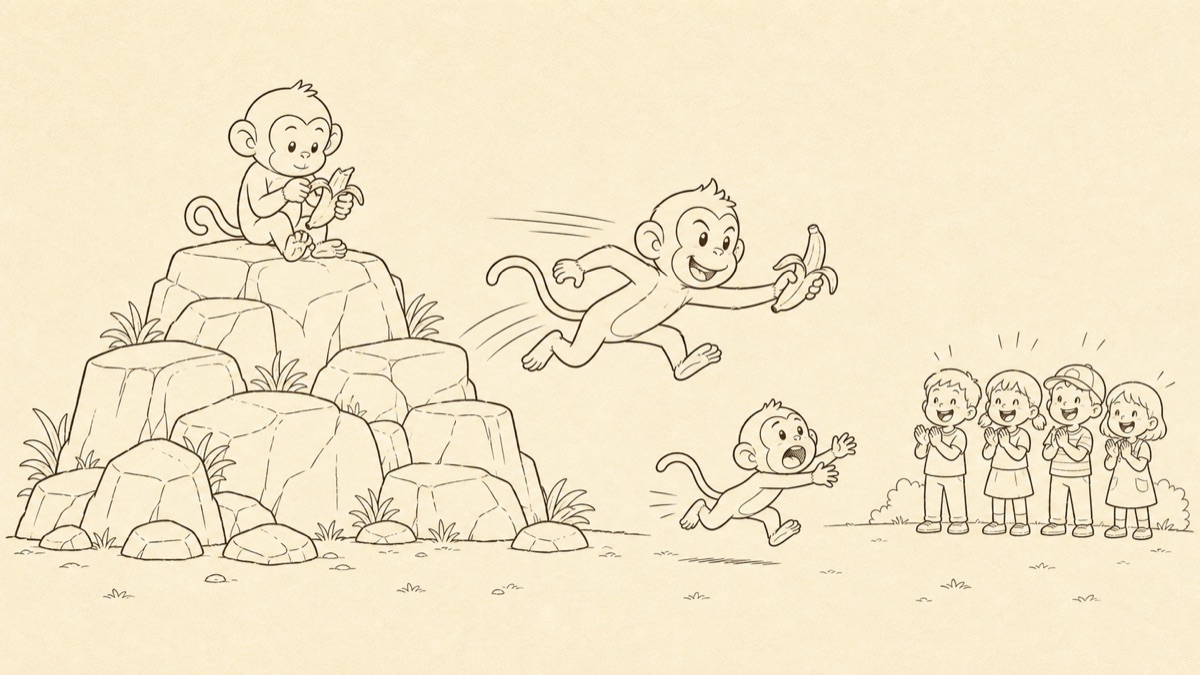
最后一条最容易翻车:生图模型特别爱在画面里加标题和箭头标注,而这些字会在笔迹动画里逐笔「写」出来,效果非常怪。
唯一的例外是手部素材 drawing-hand.png:笔杆上「江哥是老登啊」是作者签名,SKILL.md 明确允许保留,前提是用户说明了这是自己的标识。
坑在哪
有几条必须提前知道,第一条直接决定你能不能跑完。
1. macOS / Linux 上第 4 步必崩
scripts/render_annotation_preview.py 第 12 行把中文字体写死成了 Windows 路径:
font_file = "C:/Windows/Fonts/msyh.ttc"在 macOS 或 Linux 上,ImageFont.truetype 直接抛 OSError: cannot open resource。而第 4 步「生成区域预览图」是第 5 步预览台之前的强制关卡,卡在这里,整条流水线就走不下去。
有两位 contributor 分别在 8 月 19 日和 9 月 2 日提了修复(PR #2、#5,思路是按平台探测字体),到 10 月 28 日仍未合并;issue #8 里有 macOS 26.3 的实测复现。顺带一个细节:新版 macOS 上 /System/Library/Fonts/ 里没有 PingFang.ttc,实际命中 Hiragino Sans GB.ttc,自己打补丁的话别只写苹方。
临时改法很轻——把两行字体改成按平台探测即可,脚本本身只有几十行。
2. 它不负责「好看」
issue #3 有人问「为什么生成的图片很简陋」,底下讨论的结论跟 Skill 无关:出图是生图模型的事,SKILL.md 只给提示词规范。有人试着把流程拆给三家模型分工——文本模型写配图策略、生图模型出线稿、多模态模型看图做标注——反馈是组合效果还不理想。
换句话说,这套工具的上限由你手上的线稿决定,它只是把线稿变成动画。
3. 像素级标注是体力活
每个区域要原图坐标系下的整数像素 x / y / width / height,canvas 必须与原图像素尺寸一致,禁止百分比。示例是 1672×941 的图配三个区域,还应付得来;元素一多,就是纯手工拖框。
4. 单次提交,没有后续维护
2026-07-27 发布后仓库没有任何新提交,10 个 open issue 里至少 4 个是 PR(包括上面那个跨平台修复),最久的挂了两个多月。5.2k star 攒得很快,代码停在第一版。
这不必然是坏事:脚本是自包含的 Python,没有外部服务依赖,坏不了。但要清楚你拿到的是「一个能跑的快照」,不是一个在演进的项目。
5. 素材授权有疑问
issue #11 在问 assets/drawing-hand.png 的来源和商用条款,目前无人回复。要商用,自己换一只手更稳妥。
适合谁
| 适合 | 不适合 |
|---|---|
| 知识科普、课程切片、口播视频的配画面 | 需要实拍素材或复杂转场 |
| 已经有统一风格线稿(或愿意花时间出线稿)的项目 | 只想「一句话生成视频」 |
| 一次做多幕、要严格对齐叙事节奏的系列内容 | 需要画面里有文字、图表、数据可视化 |
| Windows 环境,或愿意自己打那个字体补丁 | 完全不想碰命令行和 JSON |
一点判断
这个 Skill 真正有价值的地方不在渲染器,在中间产物:annotation.json 让「这块什么时候画、对着哪句字幕」变成了一个能 review、能 diff、能反复改的文本文件。对比之下,大多数视频生成工具给你的是一个不可解释的结果,不满意只能重抽。
那套「分区掩码 + 串行笔迹 + 逐帧不露线」的骨架也不绑定白板:换成粉笔、马克笔、毛笔,或者把笔迹换成 SVG path 动画,编排层可以原样搬过去。
至于现在要不要用——机器是 Windows 的话,直接上;macOS 下先花十分钟把字体那两行改掉,再开始第一步。它停在 7 月的版本这件事,反而让「自己改两行」比「等作者合并」更现实。
本文没有在本机跑完整条流水线。结论来自 SKILL.md 全文、仓库示例产物(上面那段 GIF 就是它自己生成的),以及 issue 区的实测反馈——第 4 步在 macOS 上就断了,这一点本身就写进了「坑在哪」。